 HP G11
 قیمت سرور HP Gen 10 | مشخصات و خرید سرور اچ پی g10
 خرید سرور hp g9 | قیمت سرور اچ پی G9
 HP G8

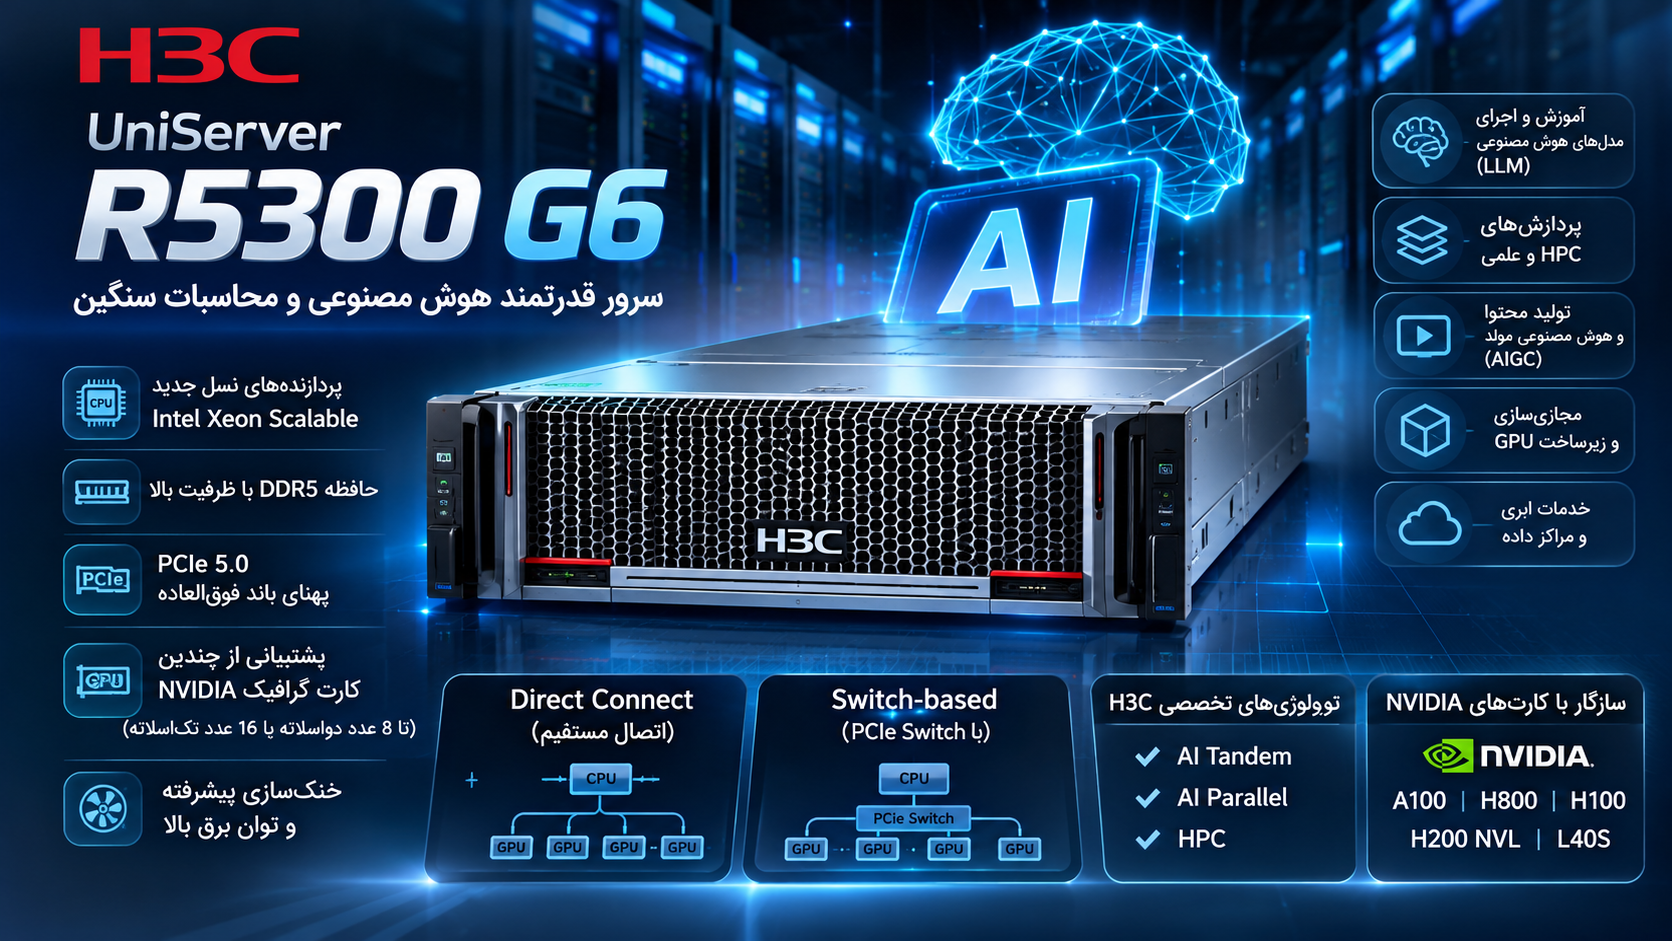
بررسی کامل سرور H3C UniServer R5300 G6؛ معماری GPU، تفاوت Direct Connect و PCIe Switch و کاربرد در هوش مصنوعی
از مشخصات CPU و رم DDR5 تا توپولوژی ۸ و ۱۰ کارت گرافیک، سازگاری شتابدهندهها، برق، خنکسازی، راهاندازی Qwen و Llama و چکلیست خرید از چین.
4U RackmountPCIe 5.0Xeon Gen4/5تا ۱۰ GPU دواسلاته*سرور H3C R5300 G6 چیست و برای چه کاری ساخته شده است؟
H3C UniServer R5300 G6 یک سرور ۴ یونیت دوپردازندهای با تمرکز بر محاسبات ناهمگن (Heterogeneous Computing) است. برخلاف سرورهای عمومی که معمولاً برای مجازیسازی، دیتابیس و فایلسرور انتخاب میشوند، این مدل برای نصب مجموعهای از شتابدهندههای پردازشی و اجرای آموزش و استنتاج یادگیری عمیق، تحلیل داده، پردازش تصویر و HPC طراحی شده است.
ویژگی کلیدی دستگاه «تنوع ماژول و توپولوژی GPU» است. بنابراین دو دستگاه R5300 G6 که از بیرون یکسان به نظر میرسند، ممکن است در داخل از نظر تعداد اسلات، نحوه اتصال کارتها، تعداد مسیرهای PCIe و عملکرد ارتباط GPUها کاملاً متفاوت باشند.
برای مثال، اجرای هشت سرویس مستقل هوش مصنوعی با آموزش یک مدل بسیار بزرگ روی هشت GPU یک مسئله یکسان نیست. در حالت اول توان هر کارت و تقسیم بار مهم است؛ در حالت دوم ارتباط سریع بین کارتها، توپولوژی PCIe، شبکه بین نودها و نرمافزار موازیسازی نقش اساسی دارند.
جدول مشخصات فنی رسمی H3C R5300 G6
| بخش | مشخصات و نکات |
|---|---|
| شاسی | 4U؛ بدون پنل امنیتی: 174.8 × 447 × 828 میلیمتر |
| CPU | حداکثر دو پردازنده Intel Xeon Scalable نسل چهارم/پنجم؛ حداکثر ۶۴ هسته برای هر پردازنده در گزینههای مجاز؛ توان CPU تا 385W |
| RAM | ۳۲ اسلات DDR5 RDIMM/LRDIMM، حداکثر 5600MT/s و ظرفیت اعلامی تا 12TB؛ تحقق سقف به CPU و DIMM وابسته است |
| GPU | ماژولهای Direct Connect و PCIe Switch؛ تا ۱۰ کارت دواسلاته یا تا ۲۰ کارت تکاسلاته، بسته به ماژول |
| PCIe | PCIe 5.0 x16 در ماژولهای دواسلاته؛ ماژول ۲۰ اسلات تکعرض از PCIe 4.0 x16 استفاده میکند |
| درایو | تا ۲۴ درایو SAS/SATA/NVMe؛ حداکثر ۸ NVMe در گزینههای اعلامی؛ دو اسلات M.2 داخلی |
| RAID | بسته به کنترلر انتخابی: 0/1/5/6/10/50/60 و گزینههای Tri-Mode |
| شبکه | OCP 3.0 و کارتهای شبکه 1/10/25/50/100/200/400GbE در پیکربندی مجاز |
| مدیریت | H3C HDM و UniSystem، پورت اختصاصی مدیریت |
| فن | ۸ فن 8056 با قابلیت تعویض حین کار و افزونگی N+1 در طراحی اعلامی |
| پاور | گزینههای 4×2000W / 2400W / 2700W Platinum و 3200W Titanium، با محدودیت پیکربندی و افزونگی N+N |
| دما | ۵ تا ۳۵ درجه سانتیگراد؛ محدوده مجاز با توجه به قطعات نصبشده تغییر میکند |
اعداد فوق از صفحه محصول رسمی سازنده استخراج شدهاند. برای خرید، باید BOM و راهنمای سختافزار همان SKU با این جدول تطبیق داده شود.
چهار ماژول GPU و تفاوت ظرفیت واقعی آنها
| نوع ماژول | اسلاتهای GPU اعلامشده | حداکثر GPU اعلامی | نکته |
|---|---|---|---|
| 8-slot Switch | ۸ دوعرض PCIe 5.0 x16 + چهار تکعرض | تا ۱۰ دوعرض* | دارای PCIe Switch؛ توپولوژی داخلی باید مشخص شود |
| 4-slot Direct | ۶ دوعرض PCIe 5.0 x16 | تا ۶ دوعرض* | برای بارهای کوچکتر یا مستقل |
| 8-slot Direct | ۱۰ دوعرض PCIe 5.0 x16 | تا ۱۰ دوعرض* | اتصال مستقیم به مسیرهای پردازنده |
| 16-slot Switch | ۲۰ تکعرض PCIe 4.0 x16 | تا ۲۰ تکعرض* | مناسب شتابدهندههای تکاسلاته سازگار |
پنج توپولوژی تشریحشده در مستند سختافزاری H3C
مستند تصویری سازنده پنج حالت اصلی را بهطور شماتیک نمایش میدهد: 4GPU Direct، 8GPU Direct، 8GPU AI Tandem، 8GPU AI Parallel و 8GPU HPC. صفحه محصول از مجموعه گستردهتری از توپولوژیها سخن میگوید؛ بنابراین برای هر سفارش باید نسخه و نام دقیق توپولوژی را از H3C دریافت کرد.
تفاوت Direct Connect و PCIe Switch چیست؟
Direct Connect؛ اتصال مستقیم GPU به پردازنده
در این ساختار GPUها به مسیرهای PCIe پردازنده متصل میشوند. مزیت آن معماری سادهتر و مناسببودن برای اجرای سرویسهای مستقل، پردازش دستهای و استنتاج موازی است. ارتباط GPUهایی که پشت CPUهای متفاوت قرار گرفتهاند ممکن است از مسیرهای بین پردازندهها عبور کند و کارایی ارتباطی به توپولوژی واقعی وابسته است.
Switch-based؛ استفاده از PCIe Switch
PCIe Switch امکان توزیع و مسیریابی اتصال چند GPU را فراهم میکند و در بعضی طراحیها ارتباط Peer-to-Peer را تسهیل میکند. اما «وجود سوئیچ» بهتنهایی به معنای پهنای باند اختصاصی کامل برای همه GPUها نیست؛ مسیر uplink ممکن است مشترک باشد. کارایی نهایی به تراشه سوئیچ، Laneها، قابلیت P2P، IOMMU/ACS و توپولوژی واقعی بستگی دارد.
| معیار | Direct Connect | PCIe Switch |
|---|---|---|
| ساختار | GPU روی مسیرهای PCIe CPU | GPU پشت یک یا چند PCIe Switch |
| پیچیدگی | کمتر | بیشتر |
| چند GPU مستقل | مناسب | مناسب |
| مدل توزیعشده | وابسته به مسیر CPU و نرمافزار | ممکن است بهبود یابد؛ تضمین ندارد |
| GPU P2P | وابسته به توپولوژی | وابسته به مدل Switch و تنظیمات |
| NVLink/NVSwitch | بهصورت خودکار ندارد | بهصورت خودکار ندارد |
| انتخاب اقتصادی | معمولاً سادهتر | بسته به اختلاف قیمت و کاربرد |
مقایسه قیمت استعلامشده از فروشنده
در استعلام مطرحشده، قیمت «Direct» برابر ۱۳٬۰۰۰ و «Switch/Interactive» برابر ۲۱٬۰۰۰ یوان عنوان شده است. این ارقام صرفاً قیمتهای اعلامی همان فروشنده هستند؛ معلوم نیست شامل چه قطعاتی میشوند و نباید قیمت روز بازار یا قیمت سرور کامل تلقی شوند.
اختلاف: ۸٬۰۰۰ یوان یا حدود ۶۱٫۵٪ بیشتر نسبت به قیمت Direct. تا زمانی که BOM هر دو نسخه مشخص نشود، مقایسه قیمت بهتنهایی مبنای خرید نیست.
AI Tandem، AI Parallel و HPC چه تفاوتی دارند؟
AI Tandem: در شماتیک سازنده برای کاربردهای مدلهای بزرگ AI معرفی شده است؛ هدف آن فراهمکردن آرایش ارتباطی مناسب برای تبادل داده میان شتابدهندههاست. AI Parallel: برای پردازشهای یادگیری عمیق و بارهای موازی معرفی شده است. HPC: برای محاسبات با کارایی بالا و تحلیل داده طراحی شده است. تفاوت دقیق در Lane mapping، تعداد سوئیچها و مسیرهای بین GPUها باید از نقشه رسمی همان ماژول خوانده شود؛ این نامها بهتنهایی بنچمارک یا تضمین سرعت نیستند.
چه کارتهای گرافیکی روی H3C R5300 G6 نصب میشوند؟
پاسخ فنی دقیق از روی مدل کارت + فرمفاکتور PCIe/SXM + توان + خنکسازی + GPU kit + نسخه BIOS/HDM تعیین میشود. در جدول زیر، «دارای مستند» به معنی وجود اشاره رسمی H3C در مستند MIG است؛ نه تأیید همه ظرفیتها، همه SKUها یا همه چیدمانهای چندکارته.
| GPU | حافظه متداول | وضعیت شواهد برای R5300 G6 | کاربرد |
|---|---|---|---|
| NVIDIA A100 PCIe | 40 / 80GB | در مستند رسمی H3C برای MIG نام برده شده؛ SKU و تعداد را تأیید کنید | Training / Inference / HPC |
| NVIDIA H800 | 80GB | در مستند رسمی H3C برای MIG نام برده شده؛ نسخه و فرمفاکتور مهم است | مدلهای بزرگ و محاسبات AI |
| Intel Data Center GPU Flex I70V | بسته به SKU | در فهرست سیستمهای تأییدشده Intel برای R5300 G6 ذکر شده | پردازش رسانه و شتابدهی |
| NVIDIA L40 / L40S | 48GB | نیازمند تأیید در Compatibility List و BOM | Inference، رندر، بینایی ماشین |
| NVIDIA T4 | 16GB | نیازمند تأیید SKU و کیت نصب | Inference سبک، ویدئو |
| NVIDIA A10 / A30 | 24GB | نیازمند تأیید سازنده | AI سازمانی و مجازیسازی GPU |
| NVIDIA H100 PCIe / H100 NVL | 80 / 94GB | برای هر نسخه تأیید رسمی مستقل لازم است | LLM و Training سنگین |
| NVIDIA H200 NVL | 141GB | سازگاری در منابع بررسیشده تأیید نشد | LLM سنگین؛ نیازمند بررسی برق/خنکسازی/NVLink |
| RTX 6000 Ada / RTX PRO 6000 Blackwell | 48 / 96GB (بسته به مدل) | نیازمند تأیید فرمفاکتور، توان و فهرست رسمی | AI، رندر و پردازش ترکیبی |
| GPUهای SXM/HGX | متنوع | نباید سازگاری را از اسلات PCIe نتیجه گرفت؛ به برد و شاسی اختصاصی نیاز دارند | آموزش مدلهای بزرگ |
R5300 G6 برای چه پروژههای هوش مصنوعی مناسب است؟
آیا برای DeepSeek و Qwen مناسب است؟
بله، از نظر کلاس دستگاه میتواند میزبان این نوع بارها باشد، اما مدل دقیق اهمیت دارد: اجرای یک مدل 7B کوانتایزشده با استنتاج یک مدل MoE بسیار بزرگ تفاوت اساسی دارد. تعداد GPU، ظرفیت VRAM، سرعت شبکه و معماری توزیع بار باید بر اساس نسخه دقیق مدل، طول کانتکست، تعداد درخواست همزمان و SLA تعیین شود.
محاسبه تقریبی VRAM برای مدلهای زبانی
جدول زیر فقط حجم تقریبی وزنهای مدل را نشان میدهد: تعداد پارامتر × بایت بهازای پارامتر. حافظه KV Cache، Activation، Runtime، Fragmentation و سربار Tensor Parallel در آن لحاظ نشده است. این اعداد بنچمارک سرعت نیستند.
| مدل فرضی | FP16/BF16 (۲ بایت) | INT8 (۱ بایت) | INT4 (نیم بایت) |
|---|---|---|---|
| 7B | 14GB | 7GB | 3.5GB |
| 14B | 28GB | 14GB | 7GB |
| 32B | 64GB | 32GB | 16GB |
| 70B | 140GB | 70GB | 35GB |
| 235B | 470GB | 235GB | 117.5GB |
| 405B | 810GB | 405GB | 202.5GB |
نمودار ظرفیت اسمی حافظه چند GPU (نمونه محاسباتی)
اعداد زیر جمع ساده ظرفیت کارتهاست؛ حافظه قابل استفاده برای یک مدل واحد به روش تقسیم مدل و سربارها بستگی دارد.
* ردیف H200 NVL صرفاً مثال ریاضی است؛ نصب ۸ کارت H200 NVL روی R5300 G6 در منابع بررسیشده تأیید نشده است.
چطور بنچمارک معتبر بگیریم؟
برای مقایسه Direct و Switch باید همان GPU، CPU، RAM، مدل AI، نسخه CUDA، درایور، Batch Size و طول Context استفاده شود. معیارهای پیشنهادی: Tokens/s، Time to First Token، Latency در P95، Throughput همزمان، GPU Utilization، پهنای باند P2P و مصرف برق از پریز. بدون تست همشرایط، هر عدد «چند برابر سریعتر» قابل اتکا نیست.
پردازنده و رم مناسب سرور
این شاسی از دو پردازنده Xeon Scalable نسل چهارم یا پنجم پشتیبانی میکند. برای بارهای GPU محور، CPU باید بتواند داده را آماده کند، توکنایز کند، شبکه و ذخیرهسازی را تغذیه کند و GPUها را بدون گلوگاه مدیریت کند. تعداد هسته بیشتر همیشه بهترین انتخاب نیست؛ تعداد Laneهای PCIe، فرکانس، توان حرارتی و سازگاری BIOS نیز مهماند.
رم DDR5 ECC در ۳۲ اسلات امکان ساخت پیکربندیهای بزرگ را فراهم میکند. برای LLM Serving باید ظرفیت RAM برای نگهداری دادهها، CPU Offload احتمالی، کش و سرویسهای جانبی محاسبه شود. عدد ۱۲ ترابایت حداکثر اعلامی سازنده است، نه الزام یا ظرفیت پیشفرض.
ذخیرهسازی، RAID و شبکه
برای سیستمعامل میتوان از درایوهای M.2 داخلی در پیکربندی مجاز استفاده کرد. برای دیتاستها و کش مدلها، NVMe پرسرعت مزیت دارد؛ برای آرشیو داده و بکاپ، SAS/SATA ظرفیت بالا مناسبتر است. حداکثر ۲۴ جایگاه و تا ۸ NVMe در گزینههای رسمی اعلام شده، ولی چیدمان واقعی به کیت جلویی وابسته است.
در خوشههای چندسروری، شبکه 100/200/400GbE یا InfiniBand بر اساس نیاز و سازگاری اهمیت زیادی دارد. پشتیبانی از کارت شبکه 400GbE در مشخصات به معنای وجود آن در دستگاه خریداریشده نیست. RAID نیز جایگزین Backup نیست.
برق، پاور، خنکسازی و رک
با چند GPU پرمصرف، طراحی برق حیاتی است. قبل از سفارش باید توان هر GPU، دو CPU، رم، فنها، NVMe، NIC و حاشیه امن را جمع زد؛ سپس محدودیت پاور در حالت افزونگی N+N بررسی شود. جمع توان اسمی پاورها الزاماً به معنای توان قابل مصرف با افزونگی فعال نیست.
دستگاه حدود ۸۲.۸ سانتیمتر عمق بدون پنل امنیتی دارد؛ عمق مفید رک، فاصله کابلها، PDU، جریان هوای سرد به گرم، دمای ورودی و وزن نهایی را پیش از خرید بررسی کنید. GPUهای Passive به جریان هوای شاسی متکیاند و کارت Active نیز باید با طراحی سرور سازگار باشد.
سه سناریوی پیشنهادی کانفیگ
چکلیست حرفهای خرید H3C R5300 G6 از چین
- پارتنامبر کامل شاسی، سال ساخت، وضعیت New/Used و شماره سریال.
- تصویر واقعی داخل سرور، ماژول GPU، Riserها و کابلهای برق.
- نام توپولوژی: 4GPU Direct / 8GPU Direct / AI Tandem / AI Parallel / HPC.
- نقشه PCIe Lane و مدل PCIe Switch؛ تأیید P2P و نتیجه تست nvidia-smi topo -m.
- فهرست رسمی GPUهای سازگار با مدل و Revision دقیق.
- پارتنامبر پاورها، تعداد فنها، هیتسینکها و وضعیت افزونگی.
- پیکربندی CPU، رم، NVMe، RAID و شبکه؛ مشخصکردن اقلام Included/Excluded.
- نسخه BIOS و HDM، سلامت دستگاه و امکان دریافت آپدیت.
- تست حداقل چندساعته تحت بار GPU با گزارش دما، توان و خطا.
- شرایط گارانتی، قطعات یدکی، بستهبندی صادراتی، وزن و هزینه حمل.
۱۰ سؤال کلیدی از فروشنده
آیا قیمت شامل GPU Module است؟ آیا PCIe Switch واقعی دارد؟ مدل چیپ چیست؟ هر GPU چند Lane دارد؟ آیا کابل برق GPUها کامل است؟ چند کارت دواسلاته با توان موردنظر واقعاً نصب میشود؟ کدام GPUها در لیست سازگاریاند؟ آیا کارتها P2P دارند؟ آیا تست بار با هشت GPU انجام شده؟ آیا BOM و ویدئوی تست ارائه میدهید؟
سؤالات متداول درباره H3C R5300 G6
آیا R5300 G6 سرور ۸ GPU است یا ۱۰ GPU؟
بسته به ماژول، تا ۱۰ GPU دواسلاته اعلام شده است. نام «8-slot» را نباید بهتنهایی تعداد نهایی GPU تفسیر کرد.
آیا نسخه Switch همیشه سریعتر است؟
خیر. عملکرد به توپولوژی، نوع پردازش، P2P و پهنای باند مسیرها وابسته است.
آیا PCIe Switch همان NVSwitch است؟
خیر. این دو فناوری متفاوتاند و هیچکدام نباید بدون مستندات جای دیگری فرض شوند.
آیا میتوان H200 NVL نصب کرد؟
در منابع بررسیشده سازگاری قطعی این مدل پیدا نشد؛ پیش از سفارش باید H3C پارتنامبر و کیت موردنیاز را تأیید کند.
آیا A100 80GB قابل استفاده است؟
H3C در مستند رسمی GPU MIG خود از A100 80GB نام میبرد؛ با این حال SKU، تعداد و کیت نصب باید بررسی شود.
برای Qwen 32B چند GPU لازم است؟
بسته به دقت وزنها، طول کانتکست و بار همزمان؛ وزنهای FP16 حدود ۶۴GB و INT4 حدود ۱۶GB هستند، بدون سربار.
آیا با ۸ GPU حافظه یکپارچه داریم؟
خیر. نرمافزارهای Tensor/Pipeline Parallel مدل را تقسیم میکنند و سربار ارتباطی وجود دارد.
آیا R5300 G6 برای رندر مناسب است؟
بله، در صورت انتخاب GPU سازگار و نرمافزار مناسب، برای رندر و پردازش تصویر هم قابل بررسی است.
آیا برای کولوکیشن مناسب است؟
بله، اما ارتفاع 4U، عمق رک، برق، گرما، وزن و محدودیت توان رک باید پیشاپیش بررسی شود.
مهمترین مدرک قبل از پرداخت چیست؟
BOM دقیق همراه با GPU Compatibility List و گزارش تست همان پیکربندی.
جمعبندی؛ کدام نسخه H3C R5300 G6 ارزش خرید دارد؟
اگر هدف اجرای چند سرویس AI مستقل باشد، Direct Connect میتواند از نظر هزینه جذابتر باشد. برای یک مدل بزرگ توزیعشده، ماژول Switch فقط وقتی ارزش هزینه اضافه دارد که نقشه توپولوژی و بنچمارک واقعی مزیت آن را برای بار کاری شما نشان دهد. در هر دو حالت، اولویت اول تطبیق GPU و کیت برق/خنکسازی با فهرست رسمی H3C است.
مشاوره و استعلام کانفیگمشاهده کارت گرافیک سرور- صفحه رسمی محصول H3C R5300 G6
- مستند رسمی توپولوژی و Hardware Highlights
- مستند رسمی H3C درباره GPU MIG و مدلهای اشارهشده
- فهرست سختافزار Red Hat برای R5300 G6
بهروزرسانی: نوامبر ۲۰۲۶. برخی امکانات با علامت * در اسناد H3C اختیاری یا وابسته به پیکربندی هستند. تصاویر شماتیک این مقاله آموزشیاند و جایگزین نقشه فنی دقیق فروشنده نیستند.