 HP G11
 قیمت سرور HP Gen 10 | مشخصات و خرید سرور اچ پی g10
 خرید سرور hp g9 | قیمت سرور اچ پی G9
 HP G8

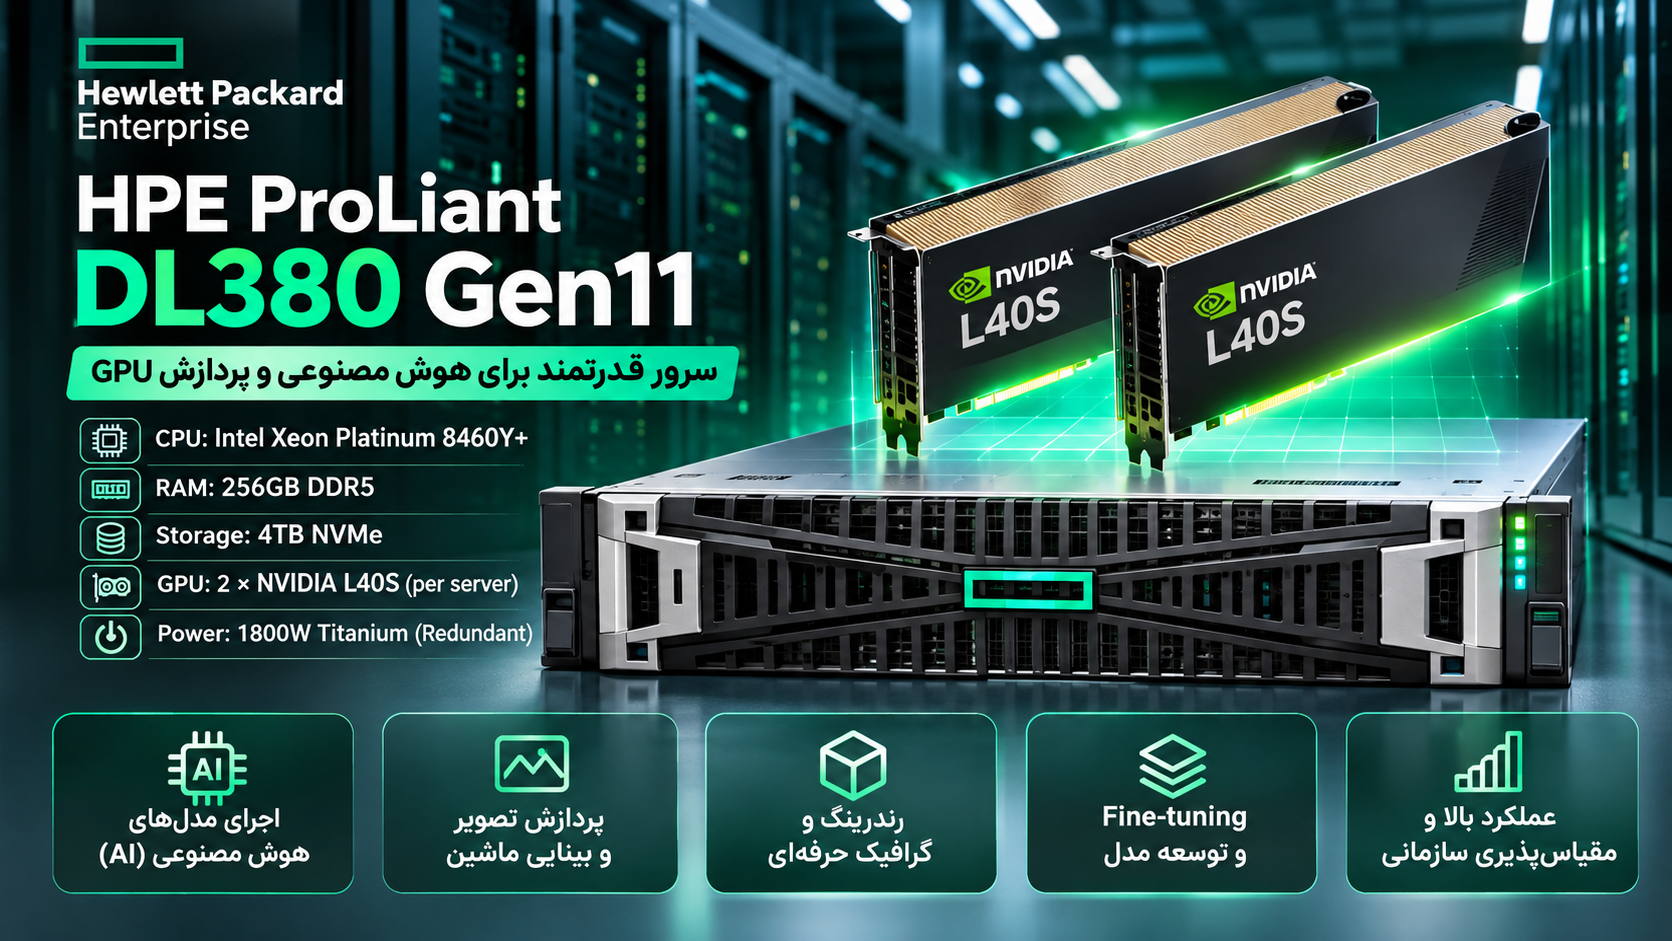
بررسی سرور HPE DL380 Gen11 با دو کارت NVIDIA L40S؛ کانفیگ، عملکرد، کاربردها و جایگزینها
تحلیل کامل سرور DL380 Gen11 با پردازنده Intel Xeon Platinum 8460Y+، رم 256GB DDR5، حافظه 4TB NVMe، دو کارت NVIDIA L40S و منبع تغذیه 1800W Titanium افزونه.
این راهنما به کاربردهای هوش مصنوعی، مدلهای زبانی، پردازش تصویر، رندرینگ، آموزش مدل، مقایسه GPUها، ارتقای CPU و طراحی معماری دو سرور میپردازد.
مشخصات کامل کانفیگ سرور
پیکربندی مورد بررسی شامل دو دستگاه HPE ProLiant DL380 Gen11 است. در هر دستگاه دو کارت NVIDIA L40S در نظر گرفته شده است.
| قطعه | مشخصات هر سرور | مجموع پروژه |
|---|---|---|
| Server | DL380 Gen11 8SFF | 2 دستگاه |
| CPU | Xeon 8460Y؛ مدل دقیق نیازمند تأیید | حداقل 2 پردازنده با فرض یک CPU در هر سرور |
| RAM | 256GB DDR5 | 512GB |
| NVMe | 4TB | 8TB |
| GPU | 2×NVIDIA L40S | 4 کارت |
| GPU VRAM | 2×48GB مستقل | 4×48GB مستقل |
| Power | 1800W Titanium Redundant | 2 مجموعه |
دو نود محاسباتی برای توزیع بار کاری.
هر سرور دارای دو شتابدهنده GPU.
چهار فضای حافظه مستقل 48GB؛ نه یک حافظه یکپارچه.
این سرور برای چه پروژههایی مناسب است؟
اجرای مدلهای زبانی، چتبات داخلی، دستیار اسناد و RAG.
تحلیل تصویر، تشخیص اشیا، کنترل کیفیت و پردازش ویدئو.
اجرای مدلهای مولد تصویر و بعضی Workflowهای تولید ویدئو.
پردازش سهبعدی و رندرینگ با نرمافزارهای سازگار.
تنظیم دقیق مدلهای قابل اجرا در ظرفیت حافظه GPU.
محیط اجرای PyTorch، مدلهای تحقیقاتی و سرویسهای GPU.
تفاوت Training و Inference
Training به آموزش یا بهروزرسانی پارامترهای مدل گفته میشود. Inference به استفاده از مدل آموزشدیده برای تولید خروجی اشاره دارد.
L40S برای بسیاری از کاربردهای Inference و بعضی فعالیتهای Fine-tuning قابل بررسی است. اما برای آموزش مدلهای بسیار بزرگ، ممکن است GPUهای دارای حافظه HBM و ارتباطات پرسرعت مناسبتر باشند.
بررسی تخصصی NVIDIA L40S 48GB
NVIDIA L40S یک شتابدهنده دیتاسنتری مبتنی بر معماری Ada Lovelace است که برای ترکیبی از هوش مصنوعی، گرافیک و پردازش موازی طراحی شده است.
| ویژگی | مشخصات |
|---|---|
| Architecture | Ada Lovelace |
| Memory | 48GB GDDR6 ECC |
| Memory Bandwidth | 864GB/s |
| CUDA Cores | 18,176 |
| FP32 Peak | 91.6 TFLOPS |
| PCIe | PCIe 4.0 x16 |
| Maximum Power | 350W |
| NVLink | ندارد |
توان محاسباتی نظری
ارقام Tensor فوق سقف نظری با Sparsity هستند. عملکرد واقعی به نوع مدل، نرمافزار، دقت محاسبات و شرایط اجرا بستگی دارد. این نمودار معیار سرعت واقعی توکن یا تصویر نیست.
آیا دو L40S حافظه 96GB یکپارچه دارند؟
خیر. هر کارت 48GB حافظه مستقل دارد. برای اجرای مدل تقسیمشده بین دو کارت، نرمافزار باید از Model Parallelism یا روشهای مشابه پشتیبانی کند.
L40S از NVLink پشتیبانی نمیکند و ارتباط میان کارتها از مسیر PCIe انجام میشود.
چه مدلهای هوش مصنوعی روی L40S اجرا میشوند؟
میزان حافظه موردنیاز مدل به تعداد پارامترها، دقت وزنها، Context، KV Cache و سربار نرمافزار بستگی دارد.
مقایسه تقریبی حافظه وزن مدلها
| مدل Dense | FP16 | INT8 تقریبی | INT4 تقریبی |
|---|---|---|---|
| 8B | 16GB | 8GB | 4GB |
| 32B | 64GB | 32GB | 16GB |
| 70B | 140GB | 70GB | 35GB |
نمودار وزن مدل در FP16
یک مدل 8B با FP16 معمولاً از نظر حافظه وزنها روی یک L40S قابل بررسی است.
برای مدلهای بزرگتر، کوانتیزاسیون یا تقسیم مدل بین GPUها ممکن است ضروری باشد.
چند کاربر همزمان پشتیبانی میشود؟
تعداد کاربران را نمیتوان تنها از تعداد GPU تعیین کرد. معیارهای مهم شامل Tokens/s، زمان اولین توکن، طول Context، تعداد درخواست همزمان و Latency هستند.
برای اندازهگیری واقعی باید مدل مشخص، موتور استنتاج و سناریوی بارگذاری تعیین شوند.
پردازنده Xeon Platinum 8460Y+ و گزینههای قویتر
در درخواست اولیه مدل 8460Y نوشته شده است. مدل رسمی قابل بررسی Intel Xeon Platinum 8460Y+ است و باید پارتنامبر نهایی تأیید شود.
Xeon Platinum 8460Y+
پشتیبانی از Hyper-Threading.
نیازمند خنکسازی سازگار.
وظیفه CPU در سرور GPU
- اجرای سیستمعامل و سرویسها
- پیشپردازش دادهها
- مدیریت درخواستها و شبکه
- آمادهسازی داده برای GPU
- مدیریت Containerها و سرویسهای AI
مقایسه تعداد هسته پردازندهها
نمودار فقط تعداد هسته را مقایسه میکند؛ نه عملکرد واقعی برنامه یا کارایی هوش مصنوعی.
حافظه 256GB DDR5؛ آیا کافی است؟
RAM سیستم برای بارگذاری دادهها، اجرای سرویسها، Cache و پیشپردازش استفاده میشود.
256GB ظرفیت مناسبی برای شروع ارزیابی بسیاری از بارهای کاری سازمانی است، اما مقدار نهایی به پروژه بستگی دارد.
سناریوهای ارتقای RAM
چیدمان RAM چرا مهم است؟
تعداد ماژولها و کانالهای فعال حافظه میتواند بر پهنای باند حافظه CPU تأثیر بگذارد.
چیدمان نهایی باید براساس تعداد CPUها و راهنمای Memory Population شرکت HPE تعیین شود.
حافظه 4TB NVMe؛ کاربرد و نکات انتخاب
NVMe یک پروتکل ذخیرهسازی پرسرعت است که معمولاً روی مسیر PCIe استفاده میشود.
در سرور AI، حافظه NVMe برای نگهداری مدلها، Datasetها، Container Imageها، Cache و دادههای موقت کاربرد دارد.
نگهداری وزن مدلها و فایلهای مربوط به اجرای AI.
ذخیره دادههای موردنیاز آموزش، آزمایش و پردازش.
کاهش وابستگی برخی پردازشها به ذخیرهسازی شبکه.
یک SSD یا چند SSD؟
عبارت 4TB NVMe بهتنهایی تعداد درایوها را مشخص نمیکند.
برای محیط عملیاتی باید تعداد SSD، نوع Enterprise، میزان Endurance، Power Loss Protection و سیاست Backup مشخص شوند.
پاور 1800W Titanium و خنکسازی GPU
هر L40S حداکثر توان 350W دارد؛ بنابراین دو کارت میتوانند تا 700W مصرف کنند.
مصرف CPU، RAM، فنها، SSD و تجهیزات شبکه نیز باید به این مقدار اضافه شود.
نمونه بودجه توان تقریبی
جمع نمونه 1200W است. این عدد یک برآورد آموزشی برای یک CPU است، نه محاسبه رسمی توان سرور.
Redundant Power یعنی چه؟
در آرایش افزونه 1+1، دو منبع تغذیه برای افزایش دسترسپذیری در نظر گرفته میشوند.
در صورت خرابی یک پاور، پاور باقیمانده باید توان موردنیاز سیستم را تأمین کند.
جایگزینهای NVIDIA L40S؛ کدام GPU مناسبتر است؟
| GPU | VRAM | کاربرد اصلی | نکته مهم |
|---|---|---|---|
| NVIDIA L4 | 24GB | استنتاج سبکتر و ویدئو | مصرف انرژی کمتر |
| NVIDIA L40 | 48GB | گرافیک و AI | توان AI متفاوت با L40S |
| NVIDIA L40S | 48GB | AI و گرافیک ترکیبی | گزینه اصلی پروژه |
| NVIDIA A100 80GB | 80GB | آموزش و محاسبات AI | حافظه HBM |
| NVIDIA H100 PCIe | 80GB | AI سنگین | هزینه و توان بالاتر |
| NVIDIA H100 NVL | 94GB | مدلهای زبانی بزرگ | نیازمند پلتفرم مناسب |
| RTX 6000 Ada | 48GB | گرافیک حرفهای و AI | سازگاری سروری باید بررسی شود |
نمودار ظرفیت VRAM هر GPU
نمودار فقط ظرفیت حافظه هر کارت را نشان میدهد. ظرفیت بیشتر لزوماً به معنی عملکرد سریعتر در تمام برنامهها نیست.
معماری دو سرور با چهار GPU چگونه طراحی میشود؟
DL380 Gen11 + 2×L40S + 256GB RAM + 4TB NVMe
DL380 Gen11 + 2×L40S + 256GB RAM + 4TB NVMe
مانیتورینگ، لاگ، مدیریت مدلها و سرویسهای مشترک.
سناریوی اول: سرویسدهی مستقل
هر سرور یک یا چند مدل را اجرا میکند و درخواستها بین نودها توزیع میشوند.
این روش برای افزایش ظرفیت و طراحی دسترسپذیری قابل بررسی است.
سناریوی دوم: مدل تقسیمشده
یک مدل بزرگ بین چند GPU تقسیم میشود. در این حالت ارتباط بین GPUها و شبکه اهمیت بیشتری پیدا میکند.
سناریوی سوم: تفکیک بار کاری
یک سرور برای LLM و RAG و سرور دیگر برای تولید تصویر یا بینایی ماشین استفاده میشود.
چه تجهیزات دیگری برای پروژه لازم است؟
- کارت شبکه مناسب مانند 25GbE یا 100GbE براساس نیاز واقعی
- سوئیچ و کابل شبکه سازگار
- سیستمعامل و درایورهای تأییدشده
- CUDA و ابزارهای اجرای مدل
- Docker یا محیط Container مناسب
- ابزارهای مانیتورینگ GPU و سرور
- سیستم Backup و کنترل دسترسی
- UPS و برق رک مناسب
- خنکسازی و تهویه دیتاسنتر
- مستندات نصب و برنامه نگهداری
چگونه عملکرد واقعی سرور AI را اندازهگیری کنیم؟
| بار کاری | معیار اندازهگیری |
|---|---|
| LLM Inference | Tokens/s و TTFT |
| Concurrent Requests | Throughput و P95 Latency |
| Image Generation | Images/min |
| Computer Vision | FPS و Latency |
| Model Training | Samples/s و زمان Epoch |
| GPU Monitoring | Utilization و VRAM Usage |
| Energy Efficiency | Performance/Watt |
بدون تعیین مدل، نوع داده، تعداد درخواستها و تنظیمات نرمافزار، نمیتوان عدد قطعی برای تعداد کاربر یا سرعت تولید خروجی اعلام کرد.
پیشنهاد بهینهسازی کانفیگ
| قطعه | کانفیگ پایه | پیشنهاد بررسی |
|---|---|---|
| Server | DL380 Gen11 8SFF | تأیید BOM و Riser |
| CPU | 8460Y | تأیید 8460Y+ و تعداد CPU |
| RAM | 256GB | بررسی چیدمان و نیاز به 512GB |
| Storage | 4TB NVMe | تعیین تعداد SSD و افزونگی |
| GPU | 2×L40S | حفظ برای AI و Graphics ترکیبی |
| Power | 1800W Redundant | تأیید بودجه توان |
| Cooling | نامشخص | تأیید Fan Kit و محدودیت دما |
| Network | نامشخص | انتخاب براساس بار کاری |
سؤالات متداول
آیا DL380 Gen11 برای هوش مصنوعی مناسب است؟
بله، در پیکربندیهای GPU سازگار میتواند برای استنتاج، پردازش تصویر و برخی پروژههای توسعه AI استفاده شود. ظرفیت و سازگاری نهایی باید بررسی شود.
آیا دو L40S معادل یک GPU با 96GB حافظه هستند؟
خیر. دو کارت حافظه مستقل دارند و برای استفاده مشترک باید نرمافزار از تقسیم مدل پشتیبانی کند.
آیا L40S برای آموزش مدل مناسب است؟
برای بعضی مدلها و Fine-tuning قابل بررسی است، اما آموزش مدلهای بسیار بزرگ ممکن است به GPUهای تخصصیتر و حافظه بیشتر نیاز داشته باشد.
آیا پردازنده 8480+ از 8460Y+ بهتر است؟
8480+ هستههای بیشتری دارد، اما عملکرد واقعی به نوع بار کاری بستگی دارد. برای پروژه GPU-محور باید ابتدا گلوگاه سیستم مشخص شود.
آیا 256GB RAM کافی است؟
برای بسیاری از سناریوهای اولیه قابل بررسی است، اما مقدار مناسب به اندازه مدل، سرویسهای جانبی و حجم داده بستگی دارد.
آیا پاور 1800W برای دو L40S کافی است؟
باید بودجه توان کامل سرور و الزامات Redundancy طبق ابزار پیکربندی HPE تأیید شود. صرف ظرفیت اسمی پاور برای تضمین کافی نیست.
چه کارت گرافیکی جایگزین L40S است؟
بسته به پروژه، L4، L40، A100، H100 یا RTX 6000 Ada قابل بررسی هستند؛ ولی سازگاری فیزیکی و رسمی با سرور باید جداگانه تأیید شود.
چه تعداد کاربر میتوانند همزمان از سرور استفاده کنند؟
تعداد کاربران به مدل، Context، Batch Size، موتور استنتاج و سطح Latency مورد انتظار بستگی دارد و باید Benchmark انجام شود.